Страницы нет в поиске по одной из 3 причин: робот о ней не знает, не смог ее получить или решил не брать. Порядок проверки от robots.txt и кодов ответа до дублей и малоценных страниц, статусы Вебмастера и Search Console, сроки переобхода.
У жалобы «сайт не индексируется» есть 3 разных значения, и чинятся они
Короткий ответ такой: если сайт не индексируется, проверять нужно в порядке от дешевого к дорогому. Сначала запреты и коды ответа, это 15 минут. Потом служебные теги noindex и canonical. Потом дубли и качество страниц. И только в конце то, как робот узнает о новых адресах. Причину показывают сами поисковики: Яндекс в Вебмастере, Google в Search Console. Ниже весь порядок с тем, где что смотреть.
Что на самом деле значит «не индексируется»
Индексирование состоит из 4 шагов. Робот узнает адрес страницы, скачивает ее, поисковик решает, включать ли ее в базу, и только потом страница начинает показываться по запросам. Обрыв возможен на любом шаге, а снаружи результат одинаковый: страницы в выдаче нет.
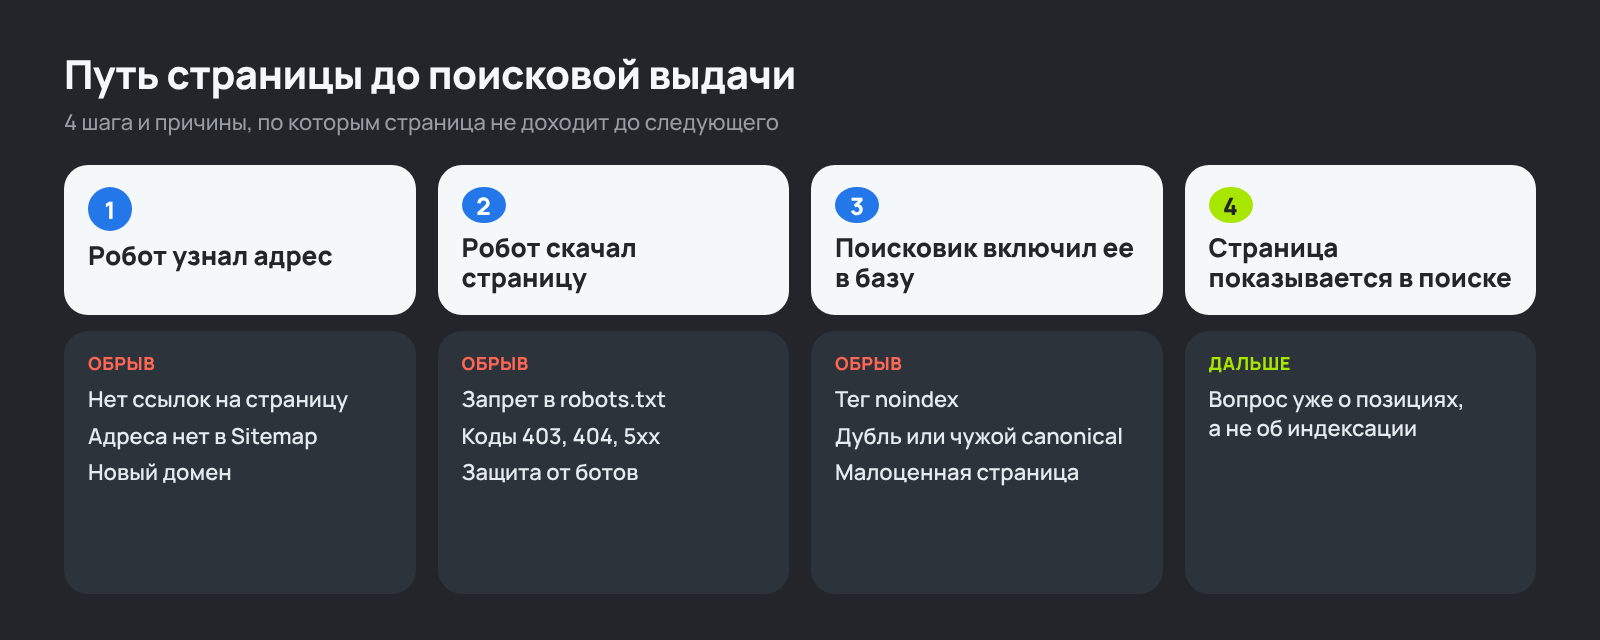
Отдельно от этих 3 случаев стоит четвертый, самый частый у новых сайтов: страница в индексе есть, но по нужным запросам ее не видно. Это уже вопрос позиций. Он решается другими средствами, и о них у нас есть статья о том, как продвинуть сайт в Яндексе. Здесь речь только о страницах, которых в базе поисковика нет совсем.
Сначала убедитесь, что страницы действительно нет в поиске
Оператор site: в строке поиска дает приблизительную картину и для диагностики не годится: число результатов округляется, часть страниц скрывается как похожие. Смотреть нужно в кабинетах.
- Яндекс. В Яндекс Вебмастере откройте «Индексирование» → «Страницы в поиске». На вкладке «Все страницы» видно, что участвует в поиске, на вкладке «Исключенные страницы» лежит список того, что робот видел и не взял, с причиной по каждому адресу. Как устроен раздел, описано в справке Вебмастера.
- Google. В Search Console откройте отчет «Индексирование» → «Страницы». Внизу отчета таблица «Почему эти страницы не индексируются» с причинами и числом адресов по каждой. Расшифровка причин есть в справке Search Console.
- Один адрес. Конкретную страницу проверяют инструментом «Проверка страницы» в Вебмастере и «Проверка URL» в Search Console: оба показывают, когда робот был на странице в последний раз, какой код ответа получил и что решил.
Если сайт в кабинеты не добавлен, начните с этого. Без них вы видите только следствие.
Дальше все зависит от того, что написано в колонке с причиной. Адреса вообще нет ни в одном списке: робот о нем не знает, переходите к разделу про карту сайта и ссылки. Адрес есть в исключенных: причина названа, и остается найти ее в разделах ниже.
Роботу закрыли вход: robots.txt, коды ответа и сервер
Это самая дешевая проверка и самая обидная находка. Сайт разрабатывали на тестовом адресе, закрыли его от поиска, а при запуске запрет переехал на боевой домен вместе с остальными файлами.
robots.txt
Откройте https://ваш-сайт/robots.txt в браузере. Вот так выглядит файл, который закрывает сайт целиком:
User-agent: *
Disallow: /
Одна косая черта после Disallow запрещает обход всего сайта. Встречаются и менее заметные варианты: закрыт раздел каталога, закрыты адреса с параметрами, а вместе с ними страницы пагинации и фильтров, которые должны были остаться. Рабочий файл для небольшого сайта обычно выглядит так:
User-agent: *
Disallow: /admin/
Disallow: /search/
Disallow: /*?sort=

Sitemap: https://example.ru/sitemap.xml
Проверить, разрешен ли конкретный адрес, можно в Вебмастере: «Инструменты» → «Анализ robots.txt», поле «Разрешены ли URL». В Search Console заблокированные адреса попадают в причину «Заблокировано в файле robots.txt».
Тут легко ошибиться в обратную сторону. Запрет в robots.txt не удаляет страницу из Google: если на нее ссылаются другие сайты, адрес может остаться в выдаче без описания. Об этом прямо сказано в документации Google. Чтобы убрать страницу из поиска, нужен noindex, а робот должен иметь возможность эту страницу прочитать.
Код ответа сервера
Страница, которая открывается в браузере, не обязательно отдает роботу код 200. Проверка занимает одну команду:
curl -I -A "Mozilla/5.0 (compatible; YandexBot/3.0)" https://example.ru/catalog/В первой строке ответа должен быть код 200. Что означают остальные:
- 301 и 302. Страница перенаправляет на другой адрес. В индекс попадет конечный адрес, а этот окажется в исключенных как редирект. Это нормально, если так и задумано.
- 403 и 401. Сервер не пускает робота. Частые причины: защита от ботов на хостинге или в сервисе фильтрации трафика, блокировка по стране, пароль на сайте, оставшийся после разработки.
- 404. Страницы нет. Если она должна быть, ищите, что сломалось в адресах после обновления или переноса.
- 5xx. Сервер отвечает ошибкой. Если это повторяется, робот снижает частоту обхода, и новые страницы начинают попадать в поиск с задержкой.
В Вебмастере то же самое показывает инструмент «Проверка ответа сервера», причем запрос идет от настоящего робота Яндекса. Это важно, когда защита от ботов пускает ваш curl, но режет робота по IP.
Есть и обратная ошибка, «ложная 404»: страница сообщает посетителю, что ничего не найдено, а сервер при этом отдает код 200. Google выносит такие адреса в отдельную причину. Встречается на пустых категориях каталога и на страницах поиска по сайту без результатов.
Роботу сказали не индексировать: noindex и canonical
Если вход открыт и код ответа 200, смотрим в код самой страницы. Запретить индексирование можно 2 способами, и второй из них не виден в исходном HTML.
<!-- в блоке head страницы -->
<meta name="robots" content="noindex, nofollow">
# в заголовках ответа сервера
X-Robots-Tag: noindexМетатег ищется поиском по исходному коду страницы (Ctrl+U, затем поиск по слову noindex). Заголовок виден только в ответе сервера, в выводе той же команды curl -I. Откуда они берутся: галочка «закрыть от индексации» в настройках CMS или
Канонический адрес
Тег canonical сообщает поисковику, какой адрес считать основным, если одно содержимое доступно по нескольким.
<link rel="canonical" href="https://example.ru/catalog/divany/">Ошибка в этом теге выключает страницы пачками. Типичные случаи: все страницы сайта ссылаются как на каноническую на главную; страницы пагинации ссылаются на первую, и товары с дальних страниц робот находит хуже; в адресе остался тестовый домен или протокол http вместо https.
Яндекс воспринимает canonical как рекомендацию и может ее проигнорировать: например, если канонический адрес недоступен или сам перенаправляет, если на странице указано несколько канонических адресов или если содержимое страниц заметно различается. Условия перечислены в справке Яндекса о каноническом адресе. Google ведет себя похоже: в отчете есть причина, когда поисковик выбрал каноническим не тот адрес, который указали вы.
Робот получил страницу и не взял ее: дубли и малоценные страницы
Самый неприятный случай. Технически все в порядке, а в колонке с причиной стоит оценка алгоритма. Ниже основные статусы и то, что за ними стоит.
| Что видно в кабинете | Что это значит | Что делать |
|---|---|---|
| Яндекс: «Дубль». Google: «Страница является копией» с разными уточнениями | Одно содержимое доступно по нескольким адресам: с параметрами и без, со слешем и без, с www и без | Оставить один адрес: редирект 301, canonical или директива Clean-param в robots.txt для Яндекса |
| Яндекс: «Неканоническая». Google: «Вариант страницы с тегом canonical» | Поисковик учел ваш canonical и показывает другой адрес | Ничего, если так задумано. Если нет, исправить тег |
| Яндекс: «Малоценная или маловостребованная страница» | Алгоритм решил, что страница вряд ли будет нужна пользователям поиска | Разбирать содержимое страницы, см. ниже |
| Google: «Страница просканирована, но пока не проиндексирована» | Робот был на странице, в базу ее не включили | То же: содержимое, дубли, внутренние ссылки |
| Google: «Обнаружена, не проиндексирована» | Адрес известен, робот до него еще не дошел | Проверить скорость ответа сервера и число ненужных адресов на сайте |
Главный вывод из таблицы: дубли и малоценные страницы лечатся на стороне сайта, кнопка переобхода здесь ничего не меняет.
Откуда берутся дубли
В интернет-магазинах дубли создают фильтры, сортировки и метки рекламных систем в адресе: ?sort=price, ?utm_source=…, ?PAGEN_1=2. Для робота каждый такой адрес может быть отдельной страницей с тем же содержимым. Когда вариантов тысячи, робот тратит на них обход, а до новых товаров добирается позже.
Для Яндекса параметры, которые не меняют содержимое, убирают директивой Clean-param:
User-agent: Yandex
Clean-param: utm_source&utm_medium&utm_campaign&yclid /
Google эту директиву не понимает, для него работают canonical и аккуратные внутренние ссылки без лишних параметров.
Что такое малоценная страница
По справке Яндекса в этот статус попадают страницы 2 видов. Малоценные: содержимое повторяет другие страницы, либо робот его не видит, потому что текст спрятан в картинке или подгружается скриптом. Маловостребованные: по оценке алгоритма, такое содержимое никто не ищет. Яндекс отдельно оговаривает, что это не нарушение и не санкция, страница может вернуться в поиск после доработки.
На практике в этом статусе чаще всего оказываются:
- карточки товаров с названием, ценой и одной фотографией, без описания и характеристик;
- пустые или почти пустые категории и страницы тегов;
- страницы-близнецы под города или услуги, где меняется одно слово;
- страницы, собранные на JavaScript так, что без исполнения скриптов в HTML нет ни заголовка, ни текста.
Последний пункт проверяется за минуту: откройте исходный код страницы (именно Ctrl+U, а не инспектор) и найдите в нем фразу из текста. Если ее там нет, робот может ее не увидеть. Google исполняет JavaScript, но делает это отдельным этапом и с задержкой, а Яндекс исполняет его не для всех сайтов.
Мое мнение: статус «малоценная» у 20 страниц из 2000 не повод для паники. Поисковик не обязан брать все, и у живого магазина в исключенных всегда лежит хвост из пустых фильтров и старых товаров. Тревожно, когда в этот статус уходят страницы, которые приносят заявки: главные категории, услуги, популярные товары. Вот их и нужно разбирать по одной.
Робот не знает о странице: карта сайта и внутренние ссылки
Если адреса нет ни среди проиндексированных, ни среди исключенных, робот до него не добрался. О новых страницах он узнает из 3 источников: ссылки с уже известных страниц, файл Sitemap и прямое сообщение от владельца.
Ссылки. Страница, на которую не ведет ни одна ссылка с других страниц сайта, для робота почти невидима, даже если она есть в карте сайта. Проверьте, что до любой важной страницы можно дойти с главной за <a href>. Меню, которое строится скриптом по клику, и кнопка «Показать еще» вместо пагинации такими ссылками не являются.
Sitemap. Файл должен быть добавлен в Вебмастере («Индексирование» → «Файлы Sitemap») и в Search Console («Индексирование» → «Файлы Sitemap»), обрабатываться без ошибок и содержать только адреса с кодом 200, без редиректов и закрытых страниц. Типичная находка: карту сгенерировали при запуске 2 года назад, и с тех пор она не обновлялась.
<url>
  <loc>https://example.ru/catalog/divany/</loc>
  <lastmod>2026-09-28</lastmod>
</url>
Новый сайт. У домена без истории и без внешних ссылок первые страницы появляются в поиске не сразу, и на это уходят недели. Это не поломка. Чего ждать в первые месяцы, мы разбирали в материале о том, как устроено
Отдельный случай: сайт переехал на новый домен или сменил структуру адресов, и индекс «обнулился». Здесь причина почти всегда в редиректах, и порядок действий у нас описан в статье о том, как перенести сайт без потери позиций.
После исправления: как сообщить поисковикам и сколько ждать
Причину устранили. Теперь поисковик должен прийти на страницу еще раз.
- Яндекс. «Индексирование» → «Переобход страниц»: вставьте адреса и отправьте. Число адресов в сутки ограничено, лимит виден в самом инструменте. По справке Яндекса робот обычно приходит в течение 3 дней, а данные в поиске обновляются в течение 2 недель после обхода.
- Google. «Проверка URL» → «Запросить индексирование». Квота тоже ограничена, поэтому отправляйте важные страницы, а не весь сайт.
- Много страниц сразу. Обновите Sitemap с актуальными датами
lastmod. В Вебмастере можно включить «Обход по счетчикам»: робот будет узнавать о страницах, на которые заходят посетители, через Яндекс Метрику. - Контроль. Через 2 недели откройте те же отчеты. В Search Console для каждой причины есть кнопка «Проверить исправление», и Google сам перепроверит адреса из списка.
Кнопку переобхода я считаю переоцененной. Она сокращает ожидание на несколько дней и не влияет на решение алгоритма. Если страницу исключили как дубль или как малоценную, повторная отправка без изменений на самой странице вернет тот же статус. Сначала правка, потом переобход.
Собирательный пример, чтобы было понятно, как это выглядит в цифрах. Магазин мебели, в карте сайта 2400 адресов, в поиске Яндекса 900. В исключенных 1100 дублей с параметрами сортировки и 350 малоценных карточек без описаний, еще 50 адресов робот не обходил. После Clean-param и канонических адресов дубли из списка уходят сами, и они в поиске не нужны. Реальная потеря здесь 400 страниц, а не 1500, и работа над ними понятна: тексты карточек и ссылки на непосещенные адреса. Цифры условные, пропорции типичные.
Частые вопросы
Сколько времени занимает индексация новой страницы?
На сайте, который робот обходит регулярно, новая страница попадает в поиск за срок от нескольких часов до нескольких дней. На новом домене первые страницы могут появляться
В Яндексе страницы есть, а в Google нет. Почему?
Поисковики обходят сайты независимо, и правила у них отличаются. Проверьте, нет ли в robots.txt отдельного блока для Googlebot, не блокирует ли хостинг или защита от ботов зарубежные
Нужно ли добиваться, чтобы в индексе были все страницы сайта?
Нет. В поиске должны быть страницы, на которые человек может прийти по запросу: категории, товары, услуги, статьи. Корзина, личный кабинет, результаты внутреннего поиска, сортировки и служебные страницы в индексе не нужны, и закрывать их правильно.
Страница была в поиске и пропала. Это то же самое?
Порядок проверки тот же, но начинать стоит с вопроса, что менялось на сайте: обновление CMS, новый шаблон, переезд, правки в robots.txt. В Вебмастере на вкладке «Последние изменения» раздела «Страницы в поиске» видна дата, когда страница выпала, и ее удобно сопоставить с датой работ.
Порядок проверки, если сайт не индексируется
Вся диагностика укладывается в 6 шагов, и первые 4 делаются без программиста:
- Открыть «Страницы в поиске» в Вебмастере и «Страницы» в Search Console, выписать причины и число адресов по каждой.
- Проверить robots.txt и код ответа важных страниц.
- Найти в коде и заголовках
noindex, сверитьcanonical. - Посмотреть, какие страницы ушли в дубли и малоценные, и есть ли среди них те, что приносят заявки.
- Обновить Sitemap и проверить внутренние ссылки на непосещенные страницы.
- Отправить исправленные адреса на переобход и вернуться к отчетам через 2 недели.
Если причин несколько и они накладываются друг на друга, быстрее пройти сайт целиком: полный список проверок есть в нашем руководстве по
 Грицук А.
 Стародубцев Д.
 Литвиненко Д.